Cobertura de código para GoAWK

Por Volodymyr Gubarkov · CTO y cofundador
- Publicado el
- 15 min de lectura
Mi investigación reveló que ninguna implementación de AWK contaba con una función de cobertura de código. La más adecuada para incorporarla resultó ser GoAWK.
Puntos clave
- La cobertura de GoAWK instrumenta el código fuente: cada bloque de un programa AWK recibe código de seguimiento y los datos recogidos se escriben en un perfil del que sale el informe.
- El perfil usa el formato propio de Go, así que go tool cover genera el informe, y las ejecuciones separadas de un programa, como muchas pruebas de CLI, pueden añadirse a un único perfil.
- La primera versión funcional usaba dos apaños y no se podía fusionar tal cual, así que el cambio llegó en dos refactorizaciones y después en una pull request limpia.
- La cobertura de GoAWK mide sentencias, no ramas: un if sin else puede parecer totalmente cubierto aunque la rama else implícita nunca se haya probado.
- Ejecutado sobre Makesure, el gestor de tareas AWK del autor, el informe de cobertura reveló código sin cubrir y ayudó a encontrar un error que ya se ha corregido.
Resumen
Contribuí al proyecto GoAWK implementando la funcionalidad de cobertura de código.
Agradezco a Ben Hoyt (el creador de GoAWK) la paciencia y la ayuda que me brindó durante todo el proceso de contribución, con revisiones de código minuciosas y llenas de criterio.
¿Qué es la cobertura de código?
En palabras sencillas, la cobertura de código es una medida que indica qué parte de su código fuente ejecutan las pruebas.
Pero ¿por qué querríamos tenerla para AWK?
Cómo surgió la idea y qué la motivó
Makesure es un gestor de tareas y comandos que estoy desarrollando. Se parece un poco a la conocida herramienta make, pero sin la mayoría de sus rarezas (¡y con un par de funciones únicas!).
Puede sonar sorprendente, pero lo escribí en AWK. No voy a mentir: escribirlo en AWK nació más de la curiosidad que de una necesidad real. Para mí, los límites fomentan la creatividad. Hoy en día pocas personas saben que AWK es un lenguaje de programación completo, aunque sumamente minimalista.
Makesure nació más bien como un experimento para ver hasta dónde se puede llegar escribiendo una herramienta en AWK. Parece que bastante lejos. No creo que sea una excepción, sino un patrón constante, debido al verdadero genio de los autores de AWK.
Por poner un ejemplo de otro proyecto escrito en AWK:
¡Escribí un compilador en awk! A bytecode; quería usar el compilador basado en awk como etapa inicial de arranque de un compilador autoalojado. De forma inquietante, funcionó bien. Para mi decepción, en realidad era más rápido que la versión autoalojada. Pero no es en absoluto el lenguaje adecuado para escribir compiladores. No contar con estructuras de datos de verdad era un problema. Aun así, quedó un código sorprendentemente limpio de unas 1,5 kloc. awk sigue siendo mi lenguaje de referencia para tareas diminutas de programación de un solo uso y para el procesamiento de texto.
La otra idea que me llevó a elegir AWK para Makesure es la facilidad de análisis sintáctico. Por ejemplo, al analizar esta sintaxis de Makesure:
@goal built
@depends_on tested
    gcc code.c
Si conoce un poco de AWK, entenderá que esta sintaxis es bastante fácil de analizar con él. AWK ya separa las palabras por usted, así que solo hace falta esto:
if      ($1 == "@goal")       handleGoal($2)
else if ($1 == "@depends_on") handleDependency($2)
else                          handleCodeLine($0)
En esencia, usar una herramienta limitada para el trabajo (AWK) le empuja a respetar el principio Peor es mejor, del que soy un gran defensor. No se inventa una sintaxis sofisticada, sino que se recurre a una que se puede analizar de forma directa.
Pasó el tiempo y el código fuente de Makesure creció hasta convertirse en un archivo awk bastante grande. La herramienta tenía un amplio conjunto de pruebas, pero yo no estaba seguro de lo buena que era la cobertura, ni de si se probaban todos los escenarios críticos.
Así, la necesidad de medir la cobertura se hizo evidente. Mi investigación reveló que ninguna implementación de AWK contaba con una función de cobertura de código. Por eso decidí añadirla a una implementación de AWK. La más adecuada para incorporarla resultó ser GoAWK.
Por supuesto, otras de mis motivaciones eran practicar mis habilidades de programación en Go y AWK.
Cómo funciona la cobertura, en términos sencillos
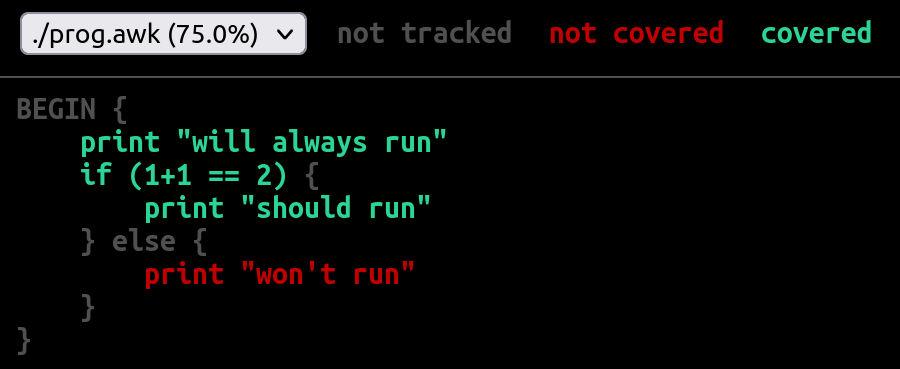
En esencia, para recoger estadísticas de cobertura de código usamos instrumentación del código fuente. Es decir, cada línea de código se anota con un fragmento de código de seguimiento (los detalles, más abajo). Así, cuando el programa instrumentado se ejecuta, el código de seguimiento se activa cada vez que se alcanza una línea de código. Al terminar el programa, todos los datos recogidos del perfil de cobertura se escriben en un archivo. Después, este archivo se usa para crear un informe de cobertura legible para las personas, como el siguiente:
En qué se diferencia la cobertura de código para AWK de la de los lenguajes más extendidos
Para probar makesure uso la herramienta tush. Ofrece una manera muy agradable y sencilla de probar una herramienta de CLI como una caja negra.
Las pruebas en tush tienen este aspecto:
$ command --that --should --execute correctly
| expected stdout output

$ command --that --will --cause error
@ expected stderr output
? expected-exit-code
(en mi caso, el command es makesure)
Al ejecutar estas pruebas, tush ejecuta todas las líneas que empiezan por $ y se limita a comparar la salida real con la esperada mediante un diff normal. Si hay alguna diferencia, la prueba falla y se muestra el diff al usuario.
En esencia, estas pruebas son pruebas de principio a fin, que se sitúan en lo más alto de la conocida pirámide de pruebas. Esto es muy bueno, ya que este estilo de pruebas equivale a la forma en que un usuario real utiliza la herramienta, lo que da muchas más probabilidades de detectar errores reales.
Con este planteamiento creé un conjunto de pruebas exhaustivo para Makesure; un archivo de pruebas típico tiene este aspecto.
El enfoque habitual para las pruebas (como en Go, Python o Java) consiste en crear un conjunto de pruebas (normalmente en varios archivos de código fuente) y luego usar un «ejecutor de pruebas» para lanzarlas todas a la vez. Y ahí está una diferencia sutil pero importante respecto al enfoque descrito antes.
Con un ejecutor de pruebas, se ejecuta una sola vez para todas las pruebas, de modo que puede formar el perfil de cobertura global cuando todas ellas han terminado.
En el caso de tush, el programa sometido a prueba (makesure y, por tanto, el awk que hay debajo) se llama muchas veces con argumentos distintos. Lo que significa que necesitamos una manera de ir ensamblando el perfil de cobertura final de forma incremental.
Esto plantea retos de implementación adicionales. Necesitamos que las ejecuciones separadas de un programa AWK puedan añadir datos a un único perfil de cobertura. Esto implica que el formato interno de este archivo debe permitir añadir datos al final, pero también exige que la herramienta de informes que consume el archivo entienda esa capacidad de añadir datos.
Cómo pensé en abordar el problema
Hace un par de años me topé con el artículo Cobertura de código para Solidity. Me resultó bastante revelador, ya que ofrecía una explicación técnica suficiente y describía los retos típicos al implementar la cobertura de código para un lenguaje de programación concreto.
El autor basó su implementación en la herramienta de cobertura Istanbul, pensada en un principio para JavaScript. Pero logró generar perfiles de cobertura para otro lenguaje (Solidity) en formato Istanbul, lo que le permitió reutilizar gratis la herramienta de informes de Istanbul.
Mi plan era usar un enfoque similar. Pero mi investigación mostró que el formato de perfil de cobertura de Istanbul no era adecuado para añadir datos al final.
La otra línea de mi reflexión vino marcada por el libro clásico The AWK Programming Language, de Alfred V. Aho, Brian W. Kernighan y Peter J. Weinberger (la A, la W y la K de AWK). Dicho sea de paso, este libro es un placer absoluto de leer y sigue siendo asombrosamente actual, a pesar de haberse publicado en 1988.
En las páginas 167-169 de este libro está la sección «7.2 Profiling». Describe un enfoque muy sencillo para implementar la elaboración de perfiles de un programa con solo dos scripts de AWK: makeprof y printprof (¡apenas tienen unas pocas líneas de código cada uno!).
makeprof realiza una transformación (reconozcámoslo, ingenua) del código fuente de entrada, insertando una sentencia de la forma _LBcnt[i]++; después de cada llave {. Luego añade una cláusula END que escribe en un archivo los recuentos de sentencias recogidos en _LBcnt.
printprof asocia los recuentos de sentencias de este archivo al programa original y muestra los recuentos junto con el código fuente original.
¡Me fascinó por completo la sencillez y la claridad de este enfoque!
A pesar de que este enfoque dista de ser perfecto y práctico, llegué a plantearme seriamente usar una versión mejorada del mismo. Sin embargo, estaba claro que, para hacerlo más preciso y fiable, tendría que transformar el AST (árbol de sintaxis abstracta) del programa AWK, y no limitarme a una modificación ingenua del código fuente.
Enfoque de implementación elegido
Mientras trabajaba de cerca con AWK en mi proyecto, un día me encontré con GoAWK. Por curiosidad, probé a ejecutar Makesure con él. Esto sacó a la luz algunos errores en GoAWK, que notifiqué y que Ben Hoyt, su creador, corrigió con prontitud. Así que, finalmente, GoAWK superó el conjunto de pruebas de Makesure.
En aquella época empecé a interesarme por aprender el lenguaje de programación Go. Por eso me alegró contribuir y corregir algunos errores menores con los que me topé. En general, me gustó mucho el proyecto GoAWK y, sobre todo, la persona que está detrás. No puedo evitar recomendar el blog técnico de Ben, muy bien escrito e interesante.
Así que pensé que, fuera cual fuera el enfoque de implementación que eligiera, me gustaría usar GoAWK como base. Como GoAWK estaba escrito en Go, decidí echar un vistazo a las funciones de cobertura del propio Go. Fue entonces cuando di con la «cover story» de Go. ¡Me convenció al instante!
La funcionalidad no era tan avanzada como la de Istanbul, pero bastaba. La implementación parecía relativamente sencilla. Pero, sobre todo, ¡su formato de perfil de cobertura parece estar diseñado pensando en poder añadir datos al final! (Aunque, que yo sepa, las propias herramientas de Go no usan directamente esta característica).
Así que decidí que deberíamos añadir la funcionalidad de cobertura de código a GoAWK, pero usando el formato de perfil de cobertura de Go, para poder reutilizar la maquinaria de Go (go tool cover) en la generación del informe final.
Intento fallido (con apaños)
Para entender mejor lo que sigue, puede resultar útil que antes lea los propios textos de Ben sobre GoAWK.
GoAWK usa patrones bastante estándar en la implementación y la estrategia de ejecución de lenguajes de programación:
- En primer lugar, el código fuente AWK de entrada (como cadena) lo procesa el Lexer, que genera una lista de tokens.
- Después, la lista de tokens sirve de entrada para el Parser, cuya salida es un AST (árbol de sintaxis abstracta).
- GoAWK también tiene la noción de Resolver, que al principio formaba parte del parser. Analiza el AST y lo anota con algunos datos adicionales, como información sobre los tipos de las variables.
- A continuación, el AST pasa por el Bytecode Compiler, que produce una lista de códigos de operación y sus argumentos (el bytecode de GoAWK).
- Por último, el bytecode sirve de entrada al Interpreter, que lleva dentro una máquina virtual. Esta ejecuta los códigos de operación instrucción a instrucción para ejecutar el programa.
Ahora tenía que entender cómo encajar la funcionalidad de cobertura de código en este esquema.
Como expliqué antes, necesitamos instrumentar el código fuente para el seguimiento de la cobertura. Es mucho más fácil de explicar con un ejemplo:
Dado el siguiente código fuente AWK:
BEGIN {
    print "will always run"
    if ((1 + 1) == 2) {
        print "should run"
    } else {
        print "won't run"
    }
}
el código instrumentado tendrá este aspecto:
BEGIN {
    __COVER["3"] = 1     # track coverage
    print "will always run"
    if ((1 + 1) == 2) {
       __COVER["1"] = 1  # track coverage
       print "should run"
    } else {
       __COVER["2"] = 1  # track coverage
       print "won't run"
    }
}
Era evidente que esta inserción del código de seguimiento debía hacerse a nivel del AST. Así que imaginé que necesitaríamos añadir un paso adicional entre el 2 y el 3: tomaría el AST como entrada, lo pasaría por un «anotador de cobertura» (aún por añadir) y produciría el AST transformado.
¡Pero en la práctica no era tan simple! El problema principal era la estrecha conexión entre el parser y el resolver. De hecho, ambos ocurrían en la misma pasada, por lo que era imposible ejecutarlos por separado.
Permítame explicar por qué esto es importante. Si me limitaba a cambiar el AST añadiendo los nodos necesarios para las sentencias __COVER["N"] = 1, esos nodos nuevos carecerían de algunos datos pequeños (pero importantes) que rellena el resolver. Así que, de alguna manera, necesitaba pasar el AST actualizado por el paso de resolución una vez más. Pero esto era técnicamente imposible, porque el resolver (al formar parte del parser) solo podía consumir lo que consume el parser (es decir, la lista de tokens).
Entonces pensé: ¿por qué no convertir el AST modificado de nuevo en código fuente AWK y empezar todo el proceso desde el paso 1? Por suerte, GoAWK ya tenía una implementación de String() para todos los nodos del AST, así que podía volver a generar código AWK a partir del AST. Por desgracia, este código AWK no tenía garantizada su corrección en todos los casos, porque su finalidad era mostrar el AST analizado con fines de depuración (la opción -d).
Fue entonces cuando introduje el primer apaño sucio: parcheé el AST instrumentado (más exactamente, los fragmentos insertados) como si lo hubiera hecho el propio Resolver.
El segundo apaño que usé fue aún más desagradable. Cuando inserté la instrumentación de cobertura así:
__COVER["2"] = 1También almaceno internamente la información que la describe, como el nombre del archivo y las líneas de código fuente cubiertas. Esta información se guarda en la trackedBlock struct.
Así que internamente tenemos lo siguiente (pseudocódigo de Go):
trackedBlocks[2] = trackedBlock{
   path:     "/path/to/script.awk",
   start:    "2:3",
   end:      "35:13",
   numStmts: 34,
}
Almacenar estos datos es necesario para construir el perfil de cobertura resultante (en el formato que usa go cover), que tiene este aspecto:
...
/path/to/script.awk:2.3,35.13 34 1
/path/to/script.awk:41.39,41.51 1 0
/path/to/script.awk:40.5,41.39 2 0
/path/to/script.awk:42.27,42.42 1 0
...
Cada línea anterior describe la cobertura recogida para algún bloque de código y tiene el siguiente formato
<source_file_path>:<column_from>.<line_from>,<column_to>.<line_to> <num_stmts> <exec_count>Ahora bien, recuerde que AWK se puede ejecutar con varios archivos de código fuente, así:
awk -f file1.awk -f file2.awk -f file3.awkPero GoAWK, en el paso 1 anterior, simplemente unía todos los archivos de código fuente en una sola cadena y la usaba como entrada del lexer.
Esto significa que, cuando tenemos el AST tras el paso 2, no hay forma de saber qué nodo del AST procede de qué archivo de entrada. Por tanto, no podemos rellenar el campo path de nuestro trackedBlock durante la instrumentación.
Así que, para pasar al AST la información de path necesaria, había que transmitirla a través del lexer y del parser, pensé. Para ello introduje un token «falso» que insertaba al principio de cada archivo. De este modo, cuando se unían los archivos de código fuente, este token representaba los límites entre archivos, lo que significaba que, al analizar, yo podía seguir la pista de los nombres de archivo y de las posiciones locales dentro de cada uno.
Refactorizaciones
Aunque el enfoque funcionaba bien en la práctica, estaba claro que era feo y que no tenía ninguna posibilidad de fusionarse tal cual. Ben elaboró una lista de observaciones de revisión de código sobre aspectos estructurales que quería ver resueltos antes de incorporar este cambio.
No había otra alternativa que emprender un par de refactorizaciones serias antes de intentar fusionar mi funcionalidad de cobertura de código.
Sinceramente, no me molestó en absoluto, ¡al contrario, me entusiasmó! En primer lugar, tuve la oportunidad de hacer un trabajo aún más útil para un proyecto que me gustaba. Y me alegré de seguir afinando mi dominio de Go.
Lo más importante para empezar era desacoplar los pasos de análisis sintáctico y de resolución. Daba un poco de miedo tocarlo. Incluso Ben describía así esta parte del código:
De hecho, el resolver fue una de las piezas de código más difíciles que he escrito en bastante tiempo. Es la única pieza del código fuente de GoAWK con la que no estoy especialmente contento. Funciona, pero es desordenada, y aún no estoy seguro de haber cubierto todos los casos límite.
Pero creo que entendí cómo funcionaba en conjunto y cómo podía hacer la refactorización. Leer los textos técnicos de Ben fue de gran ayuda.
Necesitaba una forma de recorrer (y actualizar) el AST para el paso de resolución tras el análisis sintáctico.
Para ello usé el patrón visitor, muy similar al que se usa en el propio Go. Una vez disponible la funcionalidad de visitor, el recorrido del AST necesario para la resolución resultó fácil.
Mi otra refactorización tenía como objetivo convertir las posiciones globales del código fuente unido en posiciones locales dentro de los archivos de código fuente de entrada. Esto era necesario para librarse del apaño n.º 2 mencionado antes.
Cuando ambas refactorizaciones se revisaron y se fusionaron en master, pude enviar encima mi implementación final y limpia de la cobertura de código.
En general, recomiendo mucho este enfoque para las contribuciones grandes. No debería intentar meter todos sus cambios en una sola pull request. Cada PR debería ser muy cohesiva, es decir, resolver un único problema. Así resulta mucho más fácil para el responsable del proyecto revisar y aceptar esas PR. Además, esas PR tendrán valor por sí solas, aunque no todas consigan llegar a la rama master. Como dice John Ousterhout, la descomposición de problemas es la idea más importante de toda la informática.
Resultados
Ejecutar la cobertura de GoAWK sobre Makesure reveló código sin cubrir. Esto ayudó a encontrar un error (que ya se ha corregido).
Qué falta
Como ya he mencionado, el enfoque de Go sobre la cobertura de código no es muy avanzado. Implementa cobertura de sentencias en lugar de cobertura de ramas (lo mismo vale para la cobertura de GoAWK). Por simplicidad, no cubre algunos casos límite. Otras herramientas de cobertura, como Istanbul, pueden ofrecer una cobertura más detallada, por ejemplo para las dos cláusulas de un operador ternario o para la rama else invisible.
Para ilustrar este último punto, imaginemos este código:
if (condition) {
    print "body"
}
print "after"
Puede tenerlo todo en verde y aun así algo no está cubierto: la rama «else» implícita. En otras palabras, queremos asegurarnos de que se cubren tanto la variante verdadera como la falsa de condition.
Sería estupendo mejorar esto para la cobertura de GoAWK e incluso quizá para el propio Go, pero lo dejo para trabajo futuro.
Enlaces
Artículo de Ben Hoyt sobre la cobertura de código de GoAWK
Documentación de la cobertura de GoAWK
GoAWK, un intérprete de AWK escrito en Go
The Go Blog: «The cover story», de Rob Pike
Cobertura de código para Solidity
The AWK Programming Language: el libro de los creadores de AWK, ¡de lectura obligada!
Siguiente paso
Sobre el autor
CTO y cofundador
Centrado principalmente en el desarrollo backend y la configuración de infraestructuras. Tiene una sólida experiencia en el diseño e implementación de sistemas orientados a objetos y en el desarrollo de arquitecturas de sistemas.
Más de Volodymyr GubarkovCategoría:Desarrollo de softwarePrácticas de ingeniería
Volver al blog