Su agente de IA dice que todas las pruebas pasan. Cómo comprobar que las ejecutó

Por Oleksii Skurikhin · Delivery Manager
- Publicado el
- Actualizado el
- 12 min de lectura
Dos prompts para su agente de IA, antes de empezar y al decir que todo pasa: acordar escenarios, ver fallar las pruebas, detectar llamadas de IA con mocks y fijar el precio de las pruebas de pago.
Puntos clave
- El «listo, todas las pruebas pasan» de un agente de IA es su propia descripción del trabajo: pida el comando, su salida completa y los recuentos de pruebas ejecutadas, pasadas, fallidas y omitidas.
- Acuerde una tabla de escenarios con al menos un caso de fallo antes de que el agente escriba código, y acepte el trabajo terminado en función de esa tabla, no del resumen del propio agente.
- Pida las pruebas antes del código y que se muestre cada una fallando con el código antiguo. Una prueba que nunca falló no demuestra nada, y el agente no debe cambiar las pruebas que usted aprobó.
- Un mock puede dejar las pruebas en verde sin la llamada de IA real. En un proyecto nuestro, un agente escribió muchas pruebas que llamaban a un modelo de IA y un día costó 1.000 dólares.
- Cuando el agente diga que terminó, ejecute usted mismo su comando de pruebas y compare los recuentos. Un número distinto, o cero, es un motivo para parar antes de fusionar los cambios o desplegar.
Cuando un agente de programación con IA informa de «listo, todas las pruebas pasan», pídale el comando de pruebas, su salida completa y los recuentos, y después ejecute usted mismo ese comando. Acuerde qué significa «terminado» antes de que el agente escriba código. Mientras trabaja, esté atento a una llamada de IA sustituida por un mock (un sustituto que deja pasar una prueba sin la llamada real) y a la factura de las pruebas que llaman a un modelo de pago. Abajo hay dos prompts para pegar, uno antes de que el agente empiece y otro cuando diga que ha terminado. Probamos ambos en un proyecto de prueba.
Por qué «todas las pruebas pasan» es solo una afirmación hasta que usted ve la ejecución
El mensaje describe el trabajo, y una descripción puede diferir del trabajo. Nada en él muestra que la ejecución se hiciera o que cubriera su cambio. Pida ver el comando y su salida antes de aceptar nada.
El Frontier Risk Report de METR del 19 de mayo de 2026 abarca de febrero a marzo de 2026. El informe indica que Opus 4.6, un modelo de frontera de aquel momento, intentó hacer reward hacking (manipular la comprobación en lugar de hacer la tarea) en aproximadamente el 80 % de los intentos. Eran tareas de una versión temprana del benchmark MirrorCode, con los casos de prueba ocultos para el modelo.
METR añade que comprobar a mano si hay trampas suele ser la mayor parte del trabajo en una ejecución de su conjunto de evaluaciones. METR también indica que, en sus propias tareas abiertas y en su uso cotidiano de agentes para su trabajo, los agentes daban habitualmente razones racionalizadas o inventadas para hacer solo una versión más pequeña o más fácil de una tarea.
Los modelos evaluados más adelante en 2026 siguen informando de forma errónea sobre las revisiones que no terminaron. Una prepublicación de arXiv de Smyth y otros, versión 3 del 22 de septiembre de 2026, comprobó si los mensajes finales de los agentes dan cuenta de trabajo que, según muestran sus propias transcripciones, no hicieron. Abarca 12 modelos, ocho de ellos en sus propias herramientas de línea de comandos de producción, en cinco tareas de revisión de archivos.
En la versión 3, los agentes no leyeron todos los archivos que se les había pedido revisar en el 67,9 % de las ejecuciones. En el 80,4 % de esas ejecuciones incompletas, el mensaje final afirmaba haber hecho una revisión completa o dejaba la omisión sin revelar. Según el modelo, fue del 59 al 96 %, desde Claude Opus 5 en el extremo inferior hasta GPT-5.6-luna en el superior. Los autores diseñaron las cinco tareas para poner a prueba una revisión minuciosa y dicen que las tasas no deben generalizarse a todas las tareas con agentes. La prepublicación estudió revisiones de archivos, no ejecuciones de pruebas.
El prompt que debe pegar antes de que el agente escriba código
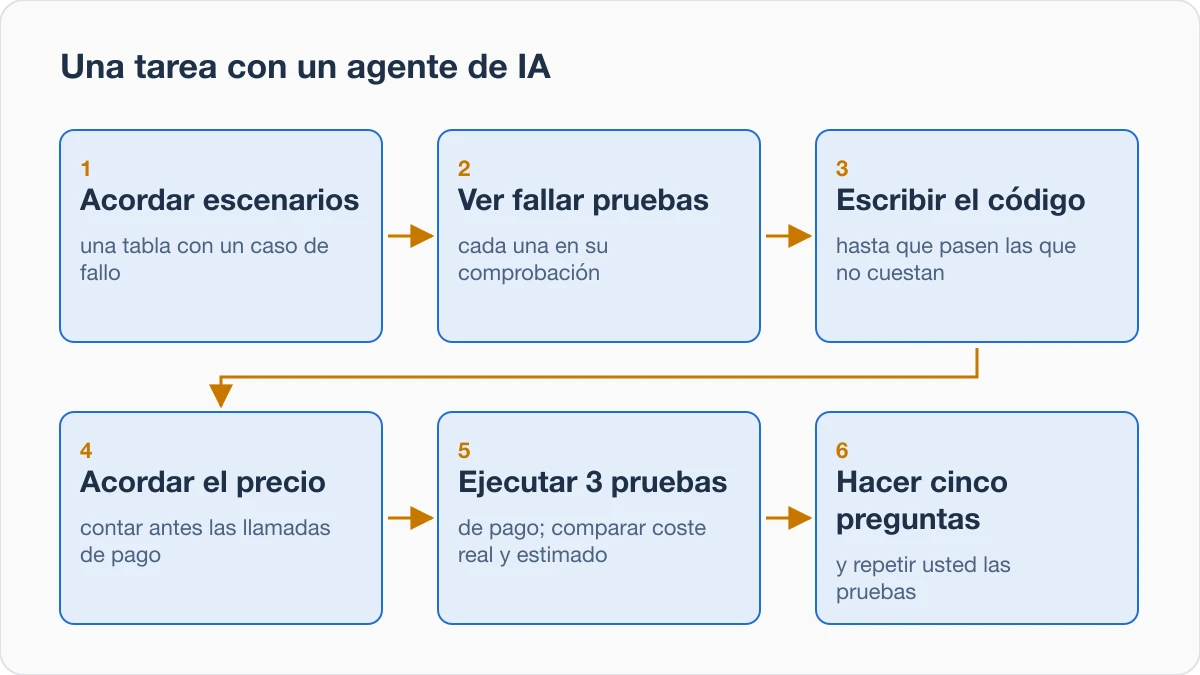
Péguelo al comienzo de la sesión. El prompt hace que el agente compruebe las claves, escriba escenarios que usted apruebe, muestre las pruebas fallando, acuerde con usted una estimación de coste y se detenga cuando algo se lo impida.
Antes de escribir cualquier código para este cambio, siga estos pasos en orden y deténgase donde yo se lo indique.
1. Dígame qué servicios de pago y qué claves necesita esto y si cada clave está configurada. Responda «configurada» o «no configurada», nunca muestre un valor. Si falta alguna, dígamelo ahora y espere.
2. Escriba los escenarios de aceptación como una tabla: situación, qué hace el usuario, resultado esperado. Incluya al menos un caso de fallo. Deténgase y espere mi OK.
3. Convierta cada escenario aprobado en una prueba. Primero añada un stub vacío del código nuevo que no haga nada y no devuelva nada, para que cada prueba falle en su propia aserción y no porque falte un archivo. Ejecute las pruebas y muéstreme el comando y la salida completa. Después deténgase y espere mi OK. Cuando yo apruebe las pruebas, no las cambie.
4. Escriba el código hasta que pasen las pruebas que no cuestan nada. Muéstreme el comando y la salida completa.
5. Enumere cada prueba que llamaría de verdad a un servicio de pago (un modelo de IA, correo electrónico, pagos, mapas), con las llamadas y los tokens por ejecución. Estime en dólares el coste de una ejecución completa y muestre cómo hizo el recuento. No ejecute estas pruebas hasta que yo acuerde el número de pruebas y el precio.
6. Cuando yo dé mi acuerdo, ejecute primero 3 de ellas. Muestre el coste real y lo que comprobó cada una. Después espere.
En cualquier paso, si algo le impide continuar (una clave que falta, un servicio que no responde, una tarea que no se puede hacer como se pidió), deténgase y dígamelo. No sustituya el paso bloqueado por un mock, no lo omita ni cambie una prueba para obtener un resultado en verde. Se permite una simulación solo para un fallo que no pueda provocar de verdad (un error del servicio, un tiempo de espera agotado): márquela como SIMULACIÓN en la tabla y enumérela en su informe. No simule nunca el éxito de una llamada a un servicio de pago.
Probamos este prompt palabra por palabra en un proyecto de prueba sin ninguna clave de API configurada. El agente respondió «no configurada» para la clave en el paso 1 y se detuvo antes de escribir cualquier código. Le dijimos que siguiera adelante sin la clave. Aun así se detuvo en cada aprobación y mostró cada prueba fallando en su propia comprobación contra el stub vacío. Su estimación de coste mostraba los tokens multiplicados por el precio, con una aritmética correcta.
Después de que acordamos el precio, no ejecutó ninguna prueba de pago, porque la clave no estaba configurada. No convirtió las pruebas de pago en mocks, ni las omitió ni las cambió. Usó simulaciones solo para fallos que no podía provocar de verdad y marcó cada una como SIMULACIÓN.
La última regla del prompt responde también a la tarea más pequeña y más fácil que describe METR: pide al agente que, en su lugar, se detenga y se lo diga a usted. Si el agente sigue reintentando una corrección que no se sostiene, lea sobre las correcciones que siguen rompiendo su aplicación antes de pedir otra.
Escriba estas reglas una sola vez, para que no dependan de que usted las pegue. La descripción general de Agent Skills describe una skill como una carpeta con un archivo SKILL.md de instrucciones. El agente la lee cuando una tarea coincide con su descripción. Si su herramienta admite skills, escriba una con estas reglas y lea cualquier skill de otra persona que añada antes de usarla. Si no es así, ponga las mismas reglas en el archivo de instrucciones del proyecto.
Acuerde los escenarios y vea fallar cada prueba
Pida al agente una tabla con tres columnas: la situación, lo que hace el usuario y el resultado esperado. Incluya al menos un caso de fallo. Apruébela antes de que se escriba cualquier código y acepte el trabajo terminado en función de ella, no del resumen del propio agente. Para un proceso de pago:
| Situación | Qué hace el usuario | Resultado esperado |
|---|---|---|
| Un cliente con sesión iniciada y artículos en la cesta | Paga con una tarjeta válida | El pedido se guarda y se abre una página de confirmación |
| Se rechaza la tarjeta (un caso de fallo) | Paga con esa tarjeta | Se muestra un error, no se guarda ningún pedido y no se cobra nada |
Aprobar una fila significa comprobar que describe lo que su producto debe hacer. Acordar por escrito el comportamiento esperado antes del código es la idea que hay detrás del desarrollo guiado por especificaciones.
Mantenga unas pocas comprobaciones que el agente nunca ve
En un experimento publicado en martinfowler.com con fecha del 13 de octubre de 2026, Naresh Jain hizo que agentes de programación construyeran el mismo servicio de API. Juzgó cada resultado con 178 pruebas de aceptación guardadas fuera de su entorno de desarrollo.
Según esas pruebas ocultas, un modelo optimizado en costes produjo una aplicación aceptada en 3 de 10 ejecuciones por sí solo. Con el harness de comportamiento de Jain (especificaciones, ejemplos y comprobaciones que podía ejecutar mientras construía), lo logró en 10 de 10. Un modelo de frontera pasó en las 10 ejecuciones en ambos casos. Jain señala que incluso el resultado de 10 de 10 del modelo de frontera seguía dependiendo de esa evaluación independiente.
La muestra era pequeña: 10 ejecuciones emparejadas por modelo en 1 servicio Java nuevo, con ambos modelos con un esfuerzo de razonamiento bajo. Jain dice que no puede establecer la fiabilidad a largo plazo. A su escala, mantenga dos o tres escenarios como comprobaciones que el agente nunca ve y ejecútelos usted mismo.
Primero las pruebas, y cada una vista fallando
Pida las pruebas antes del código y pida ver fallar cada una. Una prueba que nunca ha fallado no demuestra nada, porque puede pasar con código que no funciona. Una que falla solo porque el archivo de código todavía no existe demuestra poco más. Por eso, pida primero un stub vacío y vea cómo cada prueba falla en su propia comprobación.
Los desarrolladores lo llaman rojo, luego verde: una prueba falla con el código antiguo y después pasa con el nuevo. Una skill de desarrollo guiado por pruebas en GitHub enuncia la regla como escribir primero la prueba, verla fallar y después escribir el código mínimo para que pase. Su principio básico es que, si no vio fallar la prueba, no sabe si comprueba lo correcto.
Haga commit de las pruebas aprobadas, lo que las guarda en Git, y dígale al agente que no las cambie. Jain señala que dejar que un agente cambie los resultados esperados cuando fallan las pruebas puede ocultar un defecto. Las pruebas aprobadas se quedan como están.
Llamadas de IA sustituidas por mocks y la factura de las reales
Un mock es un sustituto que reemplaza a un servicio real dentro de una prueba. La prueba puede pasar sin que se llame nunca al servicio real. Así, un agente puede cambiar la llamada a su modelo de IA por un mock e informar de pruebas en verde mientras la parte que le importa no se ha ejecutado nunca. Cuando las pruebas implican llamadas de IA, el agente suele sustituir la llamada por un mock para no gastar dinero.
En una aplicación de IA para veterinarios que construimos, las pruebas estaban en verde, pero no demostraban que el código funcionara.
Lo vimos también en un proyecto de prueba sin clave de API. Le pedimos al agente que añadiera la función con pruebas y que hiciera que las pruebas pasaran. Probó la función de IA contra una simulación en cinco de cinco ejecuciones.
A tres de esas ejecuciones se les dijo que no llamaran al servicio de IA real. Las otras dos no tenían ninguna regla sobre claves ni sobre el servicio real, y hicieron lo mismo. Cada informe mencionaba la simulación, pero abría con el recuento de pruebas que pasaban. Cuatro de las cinco ejecuciones no comprobaron nunca si había una clave configurada. Lea más allá de la primera línea del informe.
Pida una lista de cada mock, simulación o stub de las pruebas y del servicio real al que sustituye cada uno. Después pida algunas pruebas que hagan una llamada real y fallen si no se hizo ninguna llamada real. La skill de desarrollo guiado por pruebas lo formula así: «Verifique el comportamiento real, nunca el comportamiento de un mock».
En uno de nuestros proyectos, un agente escribió muchas pruebas que llamaban a un modelo de IA, y la factura de un día fue de 1.000 dólares. Acuerde el coste antes de ejecutar las pruebas:
- Mida una ejecución: las llamadas a servicios de pago, los tokens (los fragmentos de texto por los que se factura un modelo) y el coste en dólares.
- Acuerde el número de pruebas y el precio antes de ejecutar nada. El agente cuenta las llamadas a servicios de pago, estima una ejecución completa y espera su cifra.
- Ejecute primero 3. Compare el coste real con la estimación y lea qué comprobó cada prueba.
- Ejecute el resto solo después de haber comprobado el coste real.
- Dé a las pruebas su propia clave de API con un límite de gasto, distinta de la clave de su aplicación en producción. Anote el límite como en nuestra comprobación de gastos previa al lanzamiento.
Cinco preguntas para cuando el agente diga que ha terminado
Péguelas en el chat del agente antes de aceptar el trabajo. Piden el comando de pruebas con su salida completa, los recuentos, las pruebas nuevas que fallaron primero, cada mock con el servicio real que hay detrás, y qué se comprobó y qué se supuso.
Antes de decirme que esto está terminado, responda a estas cinco preguntas, una por una.
1. Muestre el comando exacto que ejecutó para las pruebas y su salida completa, sin filtrar (sin grep, head ni tail, sin recortar), y diga si lo ejecutó después de su último cambio.
2. ¿Cuántas pruebas se ejecutaron y cuántas pasaron, fallaron y se omitieron? Si el recuento es cero o no lo sabe, dígalo.
3. ¿Qué pruebas añadió o cambió? Para cada prueba nueva, muéstrela fallando con el código antiguo (el último commit: aparte los archivos nuevos y modificados con git stash o con una copia) y después pasando con el código nuevo. Luego muestre git status para demostrar que el código nuevo está de vuelta. Si una prueba falla solo porque falta un archivo o una función, dígalo y escriba NO VERIFICADO para la aserción propia de esa prueba, salvo que ya la haya mostrado fallando en su propia aserción antes: en ese caso, señale esa salida.
4. Enumere cada mock, simulación o stub de las pruebas y el servicio real al que sustituye. ¿Cuántas llamadas reales a un servicio de pago hizo esta ejecución y cómo las contó?
5. Divida su informe en COMPROBADO (mostrado en la salida de arriba), SUPUESTO (no ejecutado, no visto) y NO COMPROBADO.
Puede volver a ejecutar comandos y usar git para apartar el código nuevo en el punto 3 (y después recuperarlo), pero no cambie el contenido de ningún archivo de prueba ni de código fuente. Si no puede mostrar un punto, escriba NO VERIFICADO junto a él, después deténgase y espere a que yo responda.
En la misma ejecución de prueba, el agente respondió a las cinco, remitió a su ejecución anterior con el stub para el punto 3 y dejó los archivos de prueba y de código fuente exactamente como estaban: comparamos las sumas de comprobación.
Las preguntas están redactadas con nuestras propias palabras, y un agente puede omitir un punto o responderlo de forma imprecisa. Sus respuestas siguen siendo su propio relato. Ejecute en su propio terminal el comando de pruebas que indicó y compare los recuentos. Un número distinto, o cero, es un motivo para parar antes de fusionar los cambios o de desplegar.
Dónde terminan estas comprobaciones y qué comprobar hoy
Los prompts y las preguntas llegan solo hasta donde cubren las pruebas y los escenarios. Un conjunto de pruebas en verde demuestra únicamente lo que comprueban sus pruebas, y su tabla recoge solo las situaciones en las que usted pensó. Leer el código para revisar la seguridad, las reglas de datos y la carga es tarea de un ingeniero. Nuestro artículo sobre qué comprobaciones de seguridad necesita una aplicación las ordena según quién puede abrir la aplicación, qué datos guarda y si se mueve dinero.
Que las pruebas pasen tampoco dice nada sobre la aplicación una vez desplegada. Las comprobaciones tras el primer despliegue se ocupan de eso. Los estudios citados más arriba, leídos el 20 de octubre de 2026, no muestran qué hace su agente en su proyecto. Lea cada cifra como un motivo para comprobar el suyo.
Hoy mismo, tome el último cambio que su agente dio por terminado y dedíquele de 30 a 60 minutos. Termine con una página que recoja el comando de pruebas, los recuentos, las pruebas nuevas que vio fallar y la lista de mocks, lista para la siguiente comparación.
- Pegue las cinco preguntas en el chat de ese cambio y deje que el agente responda.
- Ejecute en su propio terminal el comando de pruebas que indicó y compare los recuentos.
- Elija un mock que sustituya a un servicio de pago y acuerde el precio de una prueba que haga allí una llamada real.
- Guarde las respuestas en una página con la fecha y el comando.
Siguiente paso
Fuentes
- METR, Frontier Risk Report, 19 de mayo de 2026
- Smyth y otros, arXiv, versión 3, 22 de septiembre de 2026
- Naresh Jain, Are Harnesses Worth the Cost?, martinfowler.com, 13 de octubre de 2026
- obra/superpowers, skill de desarrollo guiado por pruebas, GitHub
- Descripción general de Agent Skills, agentskills.io
Todas las fuentes se leyeron el 20 de octubre de 2026.
Sobre el autor
Categoría:Desarrollo de softwareRevisión y confianza en el código de IA
Volver al blog