
Desarrollo de sistemas RAG
CML Team desarrolla sistemas RAG para productos y equipos que necesitan respuestas basadas en sus documentos y datos, con citas de la fuente. Para Nestwise construimos un copiloto de crianza basado en RAG que cita fuentes de confianza y recuerda el contexto familiar entre sesiones. En Persona, nuestra plataforma para agencias de TI, RAG ofrece información sobre perfiles y acuerdos.
Resultados de nuestros casos de éxito
70 %
Velocidad de selección de candidatos
Caso de éxito de Persona
- Por horas o a precio fijo
- NDA firmado
- Los derechos sobre el código pasan a usted tras el pago
Con la confianza de líderes del sector
Impulsamos la innovación de empresas líderes en todo el mundo
- Ver el caso
- Ver el caso
- Ver el caso
- Ver el caso
- Ver el caso
Qué construimos
Chatbots que responden con sus documentos
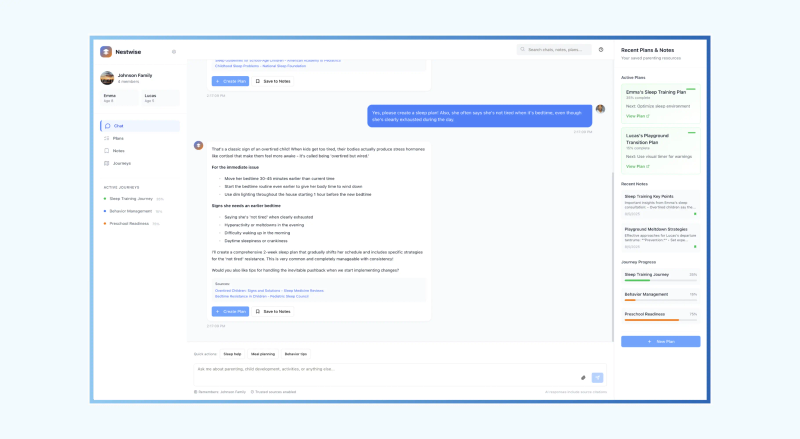
Un asistente que primero busca los pasajes relevantes y responde con lo que encuentra, con un enlace a cada fuente. Nestwise, un copiloto de crianza que entregamos como prueba de concepto funcional, da consejos basados en la evidencia con citas de fuentes de confianza.
Ver el caso de éxito de NestwiseRAG dentro del software que ya utiliza
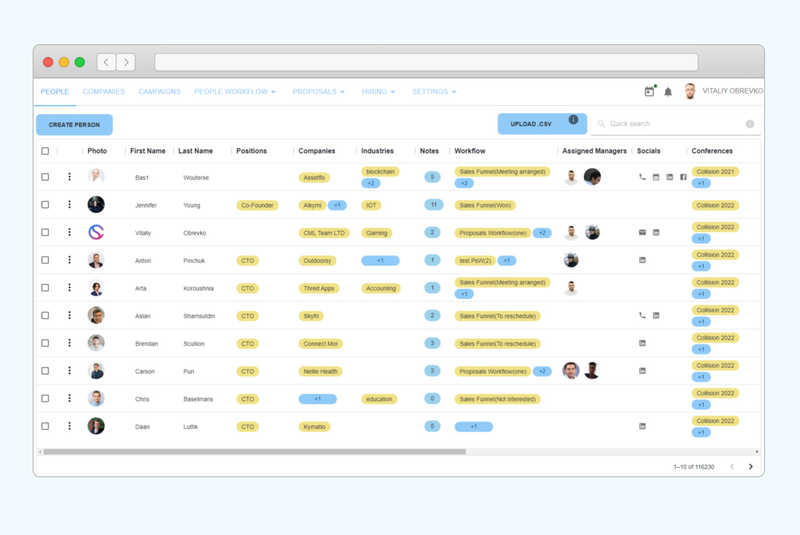
Respuestas que salen de los registros de su propia plataforma, sin una herramienta aparte. Persona, el sistema operativo de negocio de CML Team para agencias de TI, usa RAG para ofrecer información sobre perfiles y acuerdos. La misma plataforma procesa currículums, empareja candidatos y redacta correos con IA.
Ver el caso de éxito de PersonaLectura e indexación de documentos
PDF, escaneos y archivos subidos convertidos en fragmentos de texto limpios que se pueden encontrar y citar. El motor de Nestwise indexa bibliotecas de documentos preinstaladas y cargadas por los usuarios para una recuperación rápida. Persona, además, captura texto con voz a texto y OCR.
Ver el caso de éxito de NestwiseBúsqueda en sus propios contenidos
Una búsqueda en la que sus usuarios pueden confiar, primero por palabras clave y semántica donde aporta. Para ALICE, una plataforma de conserjería hotelera en la nube, desarrollamos la búsqueda de texto completo por palabras clave con Elasticsearch como parte del núcleo de la plataforma.
Ver el caso de éxito de ALICEConjuntos de referencia para probar las respuestas antes del lanzamiento
Preguntas reales con las respuestas y fuentes que usted espera, que se ejecutan tras cada cambio en los documentos, el prompt o el modelo. Así un retroceso aparece en la prueba y no en la conversación de un usuario. Construimos conjuntos de referencia en muchos de nuestros proyectos de IA.
Grafos de conocimiento para datos conectados
Construimos grafos de conocimiento junto al índice vectorial cuando la respuesta depende de los vínculos entre registros, como un producto y su línea o un contrato y sus modificaciones. Así la búsqueda sigue entidades y relaciones, no solo textos parecidos.
Cómo funciona
Cómo pasa un sistema RAG de sus documentos a una respuesta con citas
La generación aumentada por recuperación (RAG) consiste en que el sistema busca primero los pasajes que responden a una pregunta y después un modelo de lenguaje redacta la respuesta con ellos, con enlaces a la fuente. Casi todo el trabajo, y casi todos los fallos, ocurren antes de que el modelo escriba una sola palabra. Conviene planificar el proceso en siete pasos.
- Documentos. Decida de qué fuentes pueden salir las respuestas, quién se encarga de cada una y cómo se actualizan.
- Lectura y OCR. Convierta textos, tablas y escaneos en fragmentos (chunks) limpios que se puedan citar.
- Índice vectorial y de palabras clave. Guarde cada fragmento como vector semántico y como palabras para la búsqueda por palabras clave.
- Búsqueda híbrida. Combine los resultados semánticos y los de palabras clave en cada pregunta.
- Ordenación. Puntúe los candidatos frente a la pregunta y quédese solo con los pocos que la responden.
- Respuesta con citas. El modelo responde solo con esos pasajes y enlaza cada afirmación con su fuente.
- Comprobación con un conjunto de referencia. Una lista fija de preguntas reales con respuestas conocidas se ejecuta antes de cada versión.
Documentos. Empiece por las preguntas, no por los archivos. Reúna unas decenas de preguntas que sus usuarios hacen de verdad y busque los documentos que las responden. Una fuente que nadie mantiene da respuestas en las que nadie confía, así que asigne un responsable a cada una.
Lectura y OCR. Muchas respuestas erróneas empiezan aquí. Una tabla aplanada en una sola línea o una página escaneada sin capa de texto son invisibles para la búsqueda. Divida los documentos por sus encabezados y no por una longitud fija, y conserve con cada fragmento el título del documento, el encabezado y el número de página, para que la respuesta pueda citarlos.
Índice vectorial y de palabras clave. Los vectores semánticos encuentran pasajes que dicen lo mismo con otras palabras. La búsqueda por palabras clave con BM25 detecta términos exactos, como códigos de producto, nombres o números de cláusula, que una coincidencia semántica puede dejar abajo en la lista. Trabajamos con Qdrant y Pinecone como bases de datos vectoriales, y con PostgreSQL cuando los datos ya están allí.
Búsqueda híbrida y ordenación. Lance las dos búsquedas en cada pregunta y una los resultados. Después, un modelo de reordenación puntúa cada pasaje candidato frente a la pregunta, y solo los mejores llegan al modelo de lenguaje. Más contexto no significa mejor respuesta. Los pasajes que no responden a la pregunta le dan al modelo algo en lo que equivocarse. Cuando una pregunta necesita varias consultas, la recuperación agéntica permite que el modelo vuelva a buscar con una consulta más precisa antes de responder.
Respuesta con citas. Pida al modelo que responda solo con los pasajes recibidos, que cite cada uno y que lo diga cuando no contengan la respuesta. Un enlace a la fuente permite comprobar una respuesta en segundos, y un sincero "esto no está en los documentos" vale más que una suposición dicha con seguridad. Nestwise da sus consejos de crianza con citas de fuentes de confianza (caso de éxito de Nestwise). Por qué una respuesta segura puede estar equivocada lo explicamos en el artículo sobre el efecto Dr. Fox y ChatGPT.
Comprobación con un conjunto de referencia. Guarde las preguntas del primer paso, cada una con la respuesta esperada y la fuente que debería citar. Esa lista es su conjunto de referencia. Evalúe por separado la recuperación y la respuesta. Compruebe si llegó la fuente correcta y si, con esa fuente, la respuesta fue correcta. Así sabrá si un fallo nace en el índice o en el prompt. Ejecute el conjunto tras cada cambio en los documentos, el índice, el prompt o el modelo, y compare cada ejecución con la anterior.
Un chatbot que responde con sus documentos
Un chatbot así es el proyecto RAG más habitual, y el proceso anterior es su núcleo. A su alrededor está lo que el usuario nota. La conversación no pierde el contexto, cada usuario recibe respuestas solo de los documentos que puede abrir y se pueden añadir documentos nuevos sin un desarrollador. Nestwise muestra el patrón. Su motor basado en RAG recuerda el contexto familiar entre sesiones y convierte una pregunta sobre crianza en un plan de acción paso a paso. Lo entregamos como prueba de concepto funcional, que permitió al cliente validar el encaje producto-mercado y recopilar comentarios reales de los usuarios (caso de éxito de Nestwise).
Análisis de documentos con LLM cuando un error sale caro
Cuando un modelo de lenguaje lee contratos, informes o currículums, la tarea cambia. En lugar de responder a una pregunta, el sistema extrae datos y conclusiones de cada documento. Dos costumbres lo hacen seguro. Haga que el modelo señale el lugar del documento del que sale cada dato extraído, para que una persona lo compruebe con un clic. Y envíe los resultados dudosos o de alto riesgo a una persona antes de que lleguen a una decisión. Persona, nuestra propia plataforma, usa IA para procesar currículums, emparejar candidatos y validar datos de empresas (caso de éxito de Persona).
Cuándo un sistema RAG necesita un grafo de conocimiento
Un índice vectorial encuentra pasajes que se parecen a la pregunta. No sabe que un producto pertenece a una línea de productos ni que un contrato modifica otro. Un grafo de conocimiento guarda esos vínculos como entidades y relaciones, para que la búsqueda pueda seguirlos. Añádalo cuando la respuesta correcta dependa de las conexiones entre registros y no de un solo pasaje, y manténgalo junto al índice, no en su lugar. Empiece sin grafo y añádalo cuando el conjunto de referencia muestre preguntas que la búsqueda simple sigue sin responder. Construimos ambos, el índice y el grafo, y los conectamos en un mismo paso de búsqueda.
El resto de nuestro trabajo con IA, de la visión artificial a los subtítulos en directo, está en la página de casos de éxito de IA, y el servicio más amplio es transformación con IA.
Cómo trabajamos en ello
Usted nos escribe
Envíenos su caso por el formulario de contacto o escriba por LinkedIn a uno de nuestros Delivery Managers. Cuéntenos de qué documentos deben salir las respuestas y quién hará las preguntas.
- Responsable
- Usted
- Resultado
- Sus documentos y las preguntas de sus usuarios, descritos con sus propias palabras.
Decidimos qué probar primero
Lo hablamos y elegimos un pequeño conjunto de referencia, preguntas reales con las respuestas que usted espera, y los documentos que las respaldan. Puede empezar poco a poco, con consultas.
- Responsable
- Usted y CML Team
- Resultado
- Un primer conjunto de referencia y un primer paso que elige usted, sea una prueba de concepto o unas consultas.
Estimación gratuita y acuerdo
Recibe nuestra valoración de la idea y una estimación gratuita. Se factura por horas o, para un proyecto, a precio fijo. Se firma un NDA.
- Responsable
- Usted y CML Team
- Resultado
- Un acuerdo firmado y un equipo trabajando.
Prueba de concepto con sus documentos
Montamos el proceso sobre una muestra de sus documentos y le pasamos el conjunto de referencia. Usted ve las respuestas con sus citas y decide el siguiente paso.
- Responsable
- CML Team
- Resultado
- Respuestas con citas sobre sus propios documentos y los resultados del conjunto de referencia.
Desarrollo con demos periódicas
Nuestro jefe de proyecto le mantiene al día con reuniones periódicas, sesiones de planificación, demos e informes de estado. El conjunto de referencia crece en cada demo.
- Responsable
- Nuestro jefe de proyecto
- Resultado
- Software que funciona y que puede probar en cada demo.
Lanzamiento y siguientes pasos
Desplegamos el sistema. Después seguimos desarrollando con usted o lo asume su equipo interno. Los derechos sobre el código pasan a usted tras el pago.
- Responsable
- Usted y CML Team
- Resultado
- Un sistema RAG en producción y su código en sus manos.
¿Lo hablamos? Empiece con un mensaje.
Cómo puede trabajar con nosotros
Trabaje con nosotros con un equipo dedicado que se suma a sus desarrolladores, con un proyecto que gestionamos desde los requisitos hasta el lanzamiento o con especialistas bajo demanda.
Sectores y servicios relacionados
Servicios relacionados
Transformación con IA
Ver el servicioDesarrollo de MVP
Desarrollo de MVP para startups, de la prueba de concepto a producción, como hicimos con Swipelux, Levee y Health Influence.
Ver el servicioDesarrollo de CRM a medida
CRM a medida para equipos de ventas, proyectos y contratación, en web, iOS y Android.
Ver el servicio
Preguntas frecuentes
¿Cuánto se tarda en desarrollar un sistema RAG?
Primero viene una prueba de concepto con una muestra de sus documentos, que muestra el alcance real antes de comprometerse con el desarrollo completo. Nestwise, nuestro copiloto de crianza con RAG, se entregó como prueba de concepto funcional. Lo que tarda el resto depende del número de fuentes, de su estado y de lo estrictas que deban ser las comprobaciones. Una estimación gratuita le da la respuesta para su proyecto.
¿Cuánto cuesta desarrollar un sistema RAG?
Trabajamos por horas o a precio fijo, y en los dos casos el coste depende del alcance. Cuentan el número de fuentes, su estado y lo estrictas que deban ser las comprobaciones. Antes de decidir, recibe nuestra valoración de su idea y una estimación gratuita. También puede empezar poco a poco, con consultas, para definir antes el alcance.
¿Pueden añadir RAG a un producto que ya tenemos?
Sí. El índice puede funcionar junto a su producto y leer los datos y documentos que ya guarda, con los mismos permisos de acceso que tienen hoy sus usuarios. Persona es un ejemplo de RAG dentro de un producto más amplio. La plataforma gestiona ventas, proyectos y contratación para agencias de TI, y RAG es una de sus funciones de IA.
¿Con qué documentos puede trabajar un sistema RAG?
Documentos de texto, PDF, escaneos tras el OCR, páginas web y registros de su base de datos pueden servir de fuente. Lo que importa es cómo se preparan. Las tablas deben conservar sus filas y columnas, los escaneos necesitan una capa de texto y cada fragmento necesita su título y su encabezado para que la respuesta pueda citarlo. Las respuestas valen lo que valen esas fuentes, así que reserve tiempo para ordenarlas y mantenerlas al día.
¿Cómo evitan que un chatbot RAG se invente respuestas?
Con tres medidas a la vez. El modelo responde solo con los pasajes recuperados y cita cada uno. Lo dice cuando los documentos no contienen la respuesta. Y el conjunto de referencia se ejecuta tras cada cambio en los documentos, el prompt o el modelo, de modo que una respuesta errónea aparece en una prueba antes de que la reciba un usuario.
¿Qué base de datos vectorial utilizan?
Depende de dónde están sus datos y de cómo crecen. Trabajamos con Qdrant y Pinecone como bases de datos vectoriales, y con PostgreSQL cuando sus datos ya están allí. Combinamos la búsqueda semántica con la búsqueda por palabras clave BM25, porque los nombres, códigos y números exactos se escapan con facilidad a la búsqueda semántica sola.
¿Puede un sistema RAG trabajar con documentos sanitarios?
Sí, el método es el mismo y las comprobaciones son más estrictas. Use solo fuentes aprobadas por sus expertos clínicos, cite cada respuesta, prepare el conjunto de referencia junto con esos expertos y haga que una persona revise todo lo que pueda afectar a la atención al paciente. Las normas sobre datos de salud dependen de su producto y de su mercado, así que planifíquelas con sus propios asesores de cumplimiento desde el primer paso.
¿Adónde van nuestros datos cuando la IA trabaja con ellos?
Usamos soluciones autoalojadas o plataformas gestionadas como Google Vertex AI. Qué opción, qué proveedor de IA y qué reglas de uso de la IA se aplican a sus datos lo acordamos con usted antes de empezar, de modo que nada llega a un proveedor que usted no haya aprobado.
¿De quién es el código?
Firmamos un NDA, y los derechos sobre el código pasan a usted tras el pago. Después del lanzamiento, usted decide si seguimos desarrollando con usted o si su equipo interno se hace cargo del sistema y ejecuta por su cuenta el conjunto de referencia.
Lecturas relacionadas
Dos formas de ponerse en contacto
Elija la que elija, la conversación empieza con una persona.
Hable con nuestro Delivery Manager
Oleksii Skurikhin, uno de nuestros Delivery Managers, será su primer punto de contacto. Cuéntele en qué está trabajando.
Hable con nuestro Delivery Manager en LinkedIn (se abre en una pestaña nueva)Cuéntenos qué necesita
Describa la tarea en el formulario de contacto. Si quiere, añada un rango de presupuesto.
Solicite una estimación gratuita