Reescritura de las pruebas de integración de Spring Boot para acelerarlas 10 veces

Por Volodymyr Gubarkov · CTO y cofundador
- Publicado el
- 6 min de lectura
¿Cómo reducir el tiempo de ejecución de las pruebas de integración de 4 min 30 s a solo 20 s? Vamos a averiguarlo.
Puntos clave
- El CRM interno de CML Team (Java, Spring Boot, MySQL) tenía un 80 % de cobertura de pruebas en el backend, pero las de integración tardaban más de 20 minutos en el servidor de CI y aún más en local.
- Una prueba de integración tardaba más de 8 segundos, y los volcados de hilos mostraron que la mayor parte de ese tiempo la consumía Database Rider al aplicar init_data.json a la base de datos.
- Sustituir las anotaciones de Database Rider por código simple, un DbTestHelper que limpia la base de datos y un TestDataFactory que crea los datos, redujo la misma prueba a menos de un segundo.
- Tras refactorizar así 40 de unas 490 pruebas de integración, su tiempo de ejecución bajó de 4 min 30 s a 20 s y se eliminaron más de 3 mil líneas, sobre todo de archivos de datos de prueba.
- Las pruebas siguen ejecutándose sobre una base de datos MySQL real en lugar de H2, y cada una crea ahora solo los datos que necesita, por lo que su lógica es más fácil de leer, depurar y perfilar.
Así aceleramos 40 pruebas de integración de nuestro CRM interno en Spring Boot: sustituir las anotaciones de Database Rider por código de prueba simple redujo su tiempo de ejecución de 4 min 30 s a 20 s.
Descripción del problema
En CML Team estamos construyendo nuestro propio sistema CRM (por ahora interno). Desde el punto de vista tecnológico, es una aplicación web tradicional con Java + Spring Boot + MySQL en el backend y React + Next.js en el frontend.
Tenemos una cobertura de código bastante buena en el backend (alcanza el 80 %) con pruebas, pero las pruebas de integración son, como cabía esperar, bastante lentas. Su ejecución tarda más de 20 minutos en el servidor de CI. En local es aún más lenta.
No hace falta decir que esta lentitud resta mucha utilidad a las pruebas para los desarrolladores, ya que en la práctica no pueden ejecutarlas en local con la frecuencia suficiente.
Origen de la lentitud
En CML Team valoramos las pruebas de integración y funcionales. Por eso solemos escribir pruebas con menos mocks, pruebas que abarcan todas las capas de la aplicación (Java), es decir, controladores, servicios y repositorios, hasta la base de datos inclusive. Las pruebas se ejecutan sobre una base de datos real (MySQL), no sobre H2, que a menudo se recomienda.
En general, la idea es que cuanto más se parezcan sus pruebas a casos de uso reales (humanos) y a una configuración real de la aplicación, más probabilidades hay de detectar errores reales.
Por supuesto, escribimos pruebas unitarias cuando procede. Pero, por lo demás, preferimos las pruebas de principio a fin a las pruebas de un controlador, servicio o componente concreto.
Está claro que estas pruebas son lentas por naturaleza, ¡pero no deberían ser tan lentas! Era hora de mirar más a fondo para entender qué estaba pasando.
Veamos una prueba típica de las que teníamos:
@ExtendWith(SpringExtension.class)
@AutoConfigureMockMvc
@SpringBootTest
@DBRider
@DBUnit(
        leakHunter = true,
        mergeDataSets = true,
        caseSensitiveTableNames = true,
        allowEmptyFields = true)
class PersonHistoryServiceITest {
    @Test
    @WithUserDetails(value = "user1@mail.com", setupBefore = TestExecutionEvent.TEST_EXECUTION)
    @CleanDataBaseBeforeAndAfter("db_rider_data/controller/person/init_data.json")
    @ExpectedDataSet(
            value = "db_rider_data/history/person/add/data_after_save_person.json",
            ignoreCols = {"id", "person_id", "modified_at", "element_id"})
    void writeCreatingPersonToHistory() throws Exception {
        mockMvc
                .perform(
                        MockMvcRequestBuilders.post("/attendee/create")
                                .contentType(MediaType.APPLICATION_JSON)
                                .content(
                                        asJsonString(
                                                PersonCreateRequestDto.builder()
                                                        .fullName(fullName)
                                                        .country("US")
                                                        .build())))
                .andExpect(status().is2xxSuccessful());
    }
}
La prueba usa las anotaciones del proyecto Database Rider.
Como puede ver, esta prueba tiene la siguiente lógica:
- En primer lugar, vacía la base de datos y la rellena con datos iniciales en
@CleanDataBaseBeforeAndAfter(".../init_data.json") - Después, ejecuta el cuerpo del método de prueba, que realiza una llamada REST a la API que se está probando
- Por último, comprueba que el estado final de la base de datos es correcto mediante
@ExpectedDataSet(...)
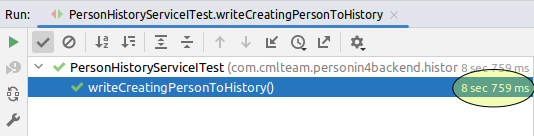
Resulta que esta prueba tarda en ejecutarse más de 8 segundos, nada menos:
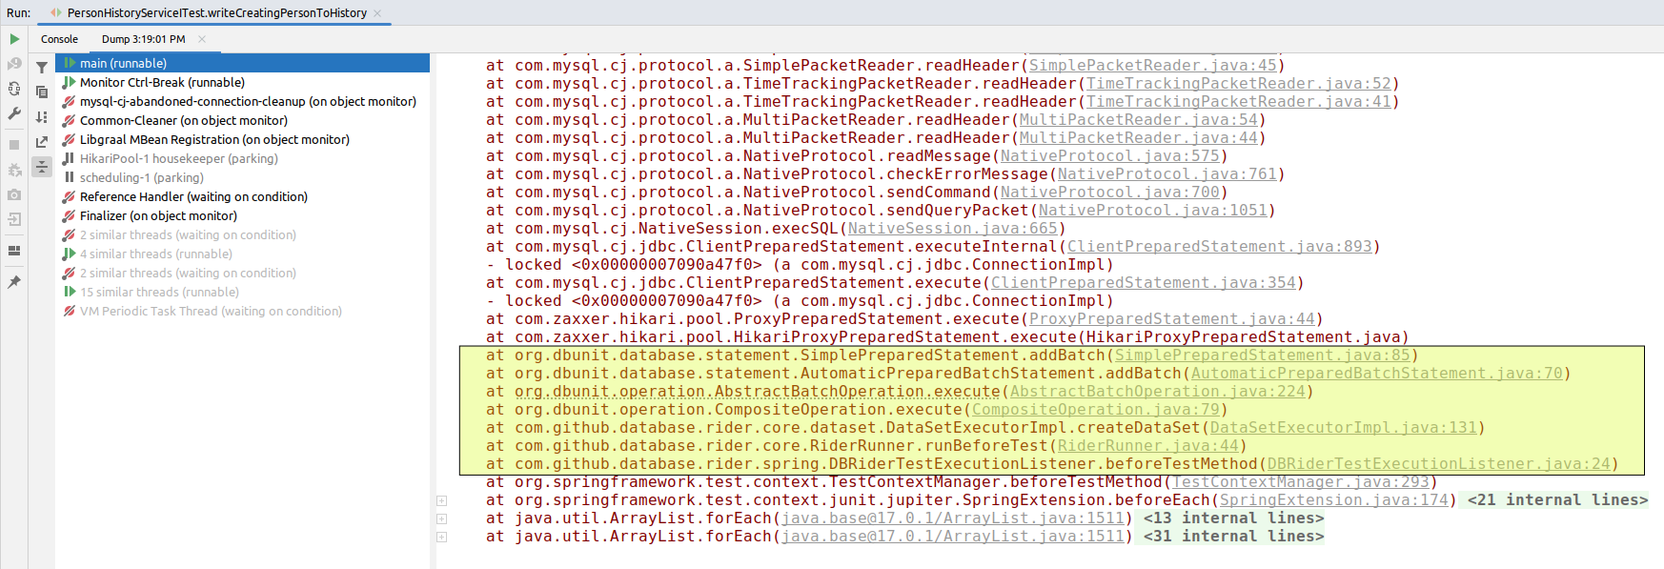
Y si tomamos algunos volcados de hilos durante la ejecución, vemos que la mayor parte de este tiempo se dedica al complemento de Database Rider aplicando el estado inicial a la base de datos (init_data.json):
Este es un extracto de init_data.json:
{
  "person": [
    {
      "id": 1,
      "country": "IE",
      "phone": "+111111111",
      "email": "john@test",
      "whatsapp": "1111111",
      "telegram": "@JohnS",
      "instagram": "@john_s",
      "facebook": "https://facebook.com/JohnS",
      "created_date": "1669125329768",
      "modified_date": "1669125329768",
      "first_name": "John",
      "last_name": "Smith",
      "outsourcing_history": "Found on clutch",
      "added_by": "IMPORTED_FROM_SPREADSHEET",
      "deleted": 0
    },
    // ...
  ],
  "avatar": [
    {
      "id": 1,
      "person_id": 1,
      "photo_url": "https://web-summit/photos/1",
      "main": 1,
      "deleted": 0
    },
    {
      "id": 2,
      "person_id": 3,
      "photo_url": "https://web-summit/photos/2",
      "main": 1,
      "deleted": 0
    },
    // ...
  ],
  "company": [
    {
      "id": 1,
      "company_funding": 100,
      "company_valuation": 25,
      "employees_amount": 60,
      "linkedin": "http://new_linked_in/good",
      "name": "Good company",
      "website": "www.good-company.com"
    },
    // ...
  ],
  "person_company": [
    {
      "company_id": 1,
      "person_id": 1
    },
    {
      "company_id": 1,
      "person_id": 2
    },
    // ...
  ],
  "conference": [
    {
      "id": 1,
      "start_date": "2022-05-06",
      "end_date": "2022-05-09",
      "link": "www.some.conference",
      "location": "San Francisco",
      "conference_name": "First conference",
      "type": "ONLINE"
    },
  ]
  // ...
}
En general, el conjunto de datos no es grande:
$ cat 'src/test/resources/db_rider_data/controller/person/init_data.json' | jq '[.[] | length] | add'
35
Así que deberían ser solo 35 inserciones SQL.
Tengo algunas hipótesis sobre por qué esto puede tardar tanto:
- Obviamente, para convertir
init_data.jsonen un conjunto de inserciones SQL, Database Rider debe determinar el orden de inserción correcto según las relaciones entre entidades (como las claves externas). Así que supongo que, como parte de esta rutina, primero tiene que obtener todos los metadatos de la base de datos y luego aplicar algún tipo de ordenación topológica al conjunto de datos de origen. - No estoy del todo seguro de lo eficiente que es Database Rider al hacer las inserciones. ¿Trabaja en modo autocommit? ¿Hace cada inserción en una transacción distinta?
- Como
init_data.jsonse comparte entre varias pruebas, es probable que contenga más datos de los necesarios para esta prueba en concreto.
La estrategia de reescritura
Dadas las dudas anteriores, la estrategia de reescritura era obvia. Deshacernos de las anotaciones de Database Rider y programar con código simple los pasos de inicialización y de comprobación de la base de datos.
Ahora la misma prueba tiene este aspecto:
@ExtendWith(SpringExtension.class)
@AutoConfigureMockMvc
@SpringBootTest
class PersonHistoryServiceITest {
  @Test
  void writeCreatingPersonToHistory() throws Exception {
    // GIVEN
    DbTestHelper.Transaction transaction = dbTestHelper.startTransactionOnCleanDb();
    User user = testDataFactory.newAdmin();
    transaction.commit();

    String fullName = "John Doe";

    // WHEN
    MvcResult result =
        mockMvc
            .perform(
                post("/attendee/create")
                    .with(user(user))
                    .contentType(MediaType.APPLICATION_JSON)
                    .content(
                        asJsonString(
                            PersonCreateRequestDto.builder()
                                .fullName(fullName)
                                .country("US")
                                .build())))
            .andExpect(status().isOk())
            .andReturn();

    // THEN
    checkPersonHistoryCreated(ITestHelper.extractId(result), user, ADD, "Person", null, fullName);
  }
}
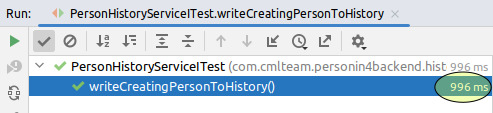
Y se ejecuta en menos de un segundo:
Así que ahora, en lugar de tener una lógica implícita oculta en anotaciones, la tenemos en el código, en las secciones // GIVEN y // THEN. De forma similar, la anotación @WithUserDetails es ahora una línea de código explícita, .with(user(user)).
El dbTestHelper encapsula la funcionalidad de limpiar la base de datos y de iniciar y confirmar las transacciones, común a muchas pruebas:
@Component
@RequiredArgsConstructor
public class DbTestHelper {
    private final EntityManager entityManager;
    private final PlatformTransactionManager platformTransactionManager;

    public interface Transaction {
        void commit();
    }

    Transaction startTransaction() {
        TransactionStatus transactionStatus =
                platformTransactionManager.getTransaction(TransactionDefinition.withDefaults());
        return () -> platformTransactionManager.commit(transactionStatus);
    }

    public Transaction startTransactionOnCleanDb() {
        Transaction transaction = startTransaction();
        cleanupDb();
        return transaction;
    }

    void cleanupDb() {
        try (Session session = entityManager.unwrap(Session.class)) {
            session.doWork(
                    connection -> {
                        Statement statement = connection.createStatement();
                        for (String table : tables) {
                            statement.addBatch("delete from personin4_integration." + table);
                        }

                        statement.executeBatch();
                    });
        }
    }

    private static final String[] tables =
            new String[]{
                    "person_industry",
                    "person_company_position",
                    "person_company"
                    // ... all other tables
            };
}
El objetivo principal de testDataFactory es generar en la base de datos los registros de datos de prueba. Por lo tanto, por defecto debería generar los mismos datos de entidad para cualquier prueba, pero también debería ofrecer una forma común de personalizar cada instancia de entidad antes de crearla (mediante EntityCustomizer):
@Component
@RequiredArgsConstructor
public class TestDataFactory {
    private final EntityManager entityManager;
    private static final EntityCustomizer nop = o -> {};

    public interface EntityCustomizer<Entity> {
        void customize(Entity entity);
    }

    private <Entity> Entity customizeAndPersist(
            EntityCustomizer<Entity> entityCustomizer, Entity entity) {
        entityCustomizer.customize(entity);
        entityManager.persist(entity);
        return entity;
    }

    public User newAdmin() {
        return newUser(user -> user.setRole(ROLE_ADMIN));
    }

    public User newUser() {
        return newUser(user -> user.setRole(ROLE_USER));
    }

    public User newUser(EntityCustomizer<User> userCustomizer) {
        return customizeAndPersist(
                userCustomizer,
                new User(
                        null,
                        true,
                        "example2@mail.com",
                        "username_2",
                        null,
                        true,
                        true,
                        true,
                        true,
                        "qwerty",
                        "John",
                        "Smith",
                        ROLE_USER,
                        null,
                        false,
                        newAccount(),
                        null,
                        null,
                        null,
                        null,
                        null,
                        null,
                        List.of(),
                        false));
    }

    public Person newPerson() {
        return newPerson(nop);
    }

    public Person newPerson(EntityCustomizer<Person> personCustomizer) {
        return customizeAndPersist(
                personCustomizer,
                Person.builder()
                        .firstName("John")
                        .lastName("Doe")
                        .email("email@example.com")
                        .phone("+123456789")
                        .outsourcingHistory("Found on clutch")
                        .personIndustries(Set.of())
                        .personCompanies(Set.of())
                        .personConferences(Set.of())
                        .cardPeople(List.of())
                        .campaigns(List.of())
                        .audios(new ArrayList<>())
                        .avatars(new HashSet<>())
                        .countryCode("US")
                        .country(new Country("US", "USA"))
                        .comments(List.of())
                        .photos(List.of())
                        .addedBy(AddedBy.IMPORTED_FROM_SPREADSHEET)
                        .createdDate(System.currentTimeMillis())
                        .modifiedDate(System.currentTimeMillis())
                        .build());
    }
    // ... other methods
}
Con este diseño puede rellenar previamente el conjunto de datos de prueba como quiera y de la forma más concisa:
    // GIVEN
    DbTestHelper.Transaction transaction = dbTestHelper.startTransactionOnCleanDb();
    User user = testDataFactory.newAdmin();
    Person person = testDataFactory.newPerson();
    Company company = testDataFactory.newCompany();
    Position position = testDataFactory.newPosition();
    Position position2 = testDataFactory.newPosition(position1 -> position1.setTitle("CEO"));
    PersonCompany personCompany = testDataFactory.newPersonCompany(person, company);
    testDataFactory.newPersonCompanyPosition(personCompany, position);
    testDataFactory.newPersonCompanyPosition(personCompany, position2);
    transaction.commit();
TestDataFactory también usa un pequeño truco, el de no emplear todos los repositorios específicos de cada tipo de entidad (como UserRepository, PersonRepository, etc.), sino persistir a través de un entityManager de más bajo nivel.
¿Por qué el nuevo enfoque es mejor?
En primer lugar, Database Rider incita a reutilizar el archivo de datos de prueba init_data.json. Esto lo hace menos eficiente, por los datos excesivos que una prueba concreta no necesita. Además, ahora las pruebas tienden a depender de los mismos datos (o de datos que se solapan), lo que dificulta cambiarlos para una prueba concreta.
En segundo lugar, las pruebas ahora son autocontenidas y no están dispersas en varios archivos, como ocurre con DB Rider. Esto hace que la lógica de la prueba sea más comprensible.
En tercer lugar, así es más fácil depurar y perfilar. Además, solo se crean los datos de prueba mínimos que necesita una prueba.
Por último, hay más oportunidades de refactorizar y menos copiar y pegar.
Para ilustrar este último punto, veamos el conjunto de pruebas (repetitivas) que teníamos antes de la refactorización:
@Test
  @WithUserDetails(value = "user1@mail.com", setupBefore = TestExecutionEvent.TEST_EXECUTION)
  @CleanDataBaseBeforeAndAfter("db_rider_data/controller/person/init_data.json")
  @ExpectedDataSet(
      value = "db_rider_data/history/person/edit/data_after_editing_first_name.json",
      ignoreCols = {"id", "person_id", "modified_at"})
  void writeEditingFirstNameToHistory() throws Exception {
    PersonUpdateRequestDto updateRequestDto =
        PersonUpdateRequestDto.builder()
            .personId(1L)
            .phone("+111111111")
            .email("john@test")
            .whatsapp("222222")
            .telegram("@JohnS")
            .instagram("@john_s")
            .facebook("https://facebook.com/JohnS")
            .firstName("Peter")
            .build();

    mockMvc
        .perform(
            put(domainConfig.getAppBaseUrl() + "/attendee/update")
                .contentType(MediaType.APPLICATION_JSON)
                .content(asJsonString(updateRequestDto)))
        .andExpect(status().is2xxSuccessful());
  }

  @Test
  @WithUserDetails(value = "user1@mail.com", setupBefore = TestExecutionEvent.TEST_EXECUTION)
  @CleanDataBaseBeforeAndAfter("db_rider_data/controller/person/init_data.json")
  @ExpectedDataSet(
      value = "db_rider_data/history/person/edit/data_after_editing_last_name.json",
      ignoreCols = {"id", "person_id", "modified_at"})
  void writeEditingLastNameToHistory() throws Exception {
    PersonUpdateRequestDto updateRequestDto =
        PersonUpdateRequestDto.builder()
            .personId(1L)
            .phone("+111111111")
            .email("john@test")
            .whatsapp("222222")
            .telegram("@JohnS")
            .instagram("@john_s")
            .facebook("https://facebook.com/JohnS")
            .lastName("Doe")
            .build();

    mockMvc
        .perform(
            put(domainConfig.getAppBaseUrl() + "/attendee/update")
                .contentType(MediaType.APPLICATION_JSON)
                .content(asJsonString(updateRequestDto)))
        .andExpect(status().is2xxSuccessful());
  }

  @Test
  @WithUserDetails(value = "user1@mail.com", setupBefore = TestExecutionEvent.TEST_EXECUTION)
  @CleanDataBaseBeforeAndAfter("db_rider_data/controller/person/init_data.json")
  @ExpectedDataSet(
      value = "db_rider_data/history/person/edit/data_after_editing_country.json",
      ignoreCols = {"id", "person_id", "modified_at"})
  void writeEditingCountryToHistory() throws Exception {
    PersonUpdateRequestDto updateRequestDto =
        PersonUpdateRequestDto.builder()
            .personId(1L)
            .phone("+111111111")
            .email("john@test")
            .whatsapp("222222")
            .telegram("@JohnS")
            .instagram("@john_s")
            .facebook("https://facebook.com/JohnS")
            .country("UA")
            .build();

    mockMvc
        .perform(
            put(domainConfig.getAppBaseUrl() + "/attendee/update")
                .contentType(MediaType.APPLICATION_JSON)
                .content(asJsonString(updateRequestDto)))
        .andExpect(status().is2xxSuccessful());
  }

  // ... even more tests like this
Y este es el resultado después:
 @Test
  void writeEditingFirstNameToHistory() throws Exception {
    writeEditingOfSingleFieldToHistory(
        new EditingOfSingleField(
            "Name",
            "NewName",
            Person::getFirstName,
            PersonUpdateRequestDto.PersonUpdateRequestDtoBuilder::firstName));
  }

  @Test
  void writeEditingLastNameToHistory() throws Exception {
    writeEditingOfSingleFieldToHistory(
        new EditingOfSingleField(
            "Surname",
            "NewName",
            Person::getLastName,
            PersonUpdateRequestDto.PersonUpdateRequestDtoBuilder::lastName));
  }

  @Test
  void writeEditingCountryToHistory() throws Exception {
    writeEditingOfSingleFieldToHistory(
        new EditingOfSingleField(
            "Country",
            "UA",
            Person::getCountryCode,
            PersonUpdateRequestDto.PersonUpdateRequestDtoBuilder::country));
  }

  // ... more like this
Impresionante, ¿verdad?
Resultados
Hasta ahora solo se han refactorizado de esta forma 40 pruebas de integración (de unas 490).
El tiempo de ejecución de estas pruebas bajó de 4 min 30 s a solo 20 s. ¡Es una aceleración asombrosa de 13 veces!
Y aunque cueste creerlo, también pudimos eliminar más de 3 mil líneas con este cambio (sobre todo por dejar de usar los archivos de datos de prueba):

En un futuro próximo tenemos previsto reescribir el resto de las pruebas y usar este enfoque para las pruebas nuevas.
Siguiente paso
Sobre el autor
CTO y cofundador
Centrado principalmente en el desarrollo backend y la configuración de infraestructuras. Tiene una sólida experiencia en el diseño e implementación de sistemas orientados a objetos y en el desarrollo de arquitecturas de sistemas.
Más de Volodymyr GubarkovCategoría:Desarrollo de softwarePrácticas de ingeniería
Volver al blog